高校科研项目的产出,卡点常常不在研究本身。课题申报书、中期检查、结题验收、成果归档,每一环都要把分散在多人手里的材料重新收拢一遍。我们为高校提供IT与智能化服务的过程中,看到同一条规律:团队的算力与设备并不短缺,缺口在文档与人之间的衔接。
AI千问办公WorkBuddy要解决的就是这段衔接。它的定位不是替代研究者做判断,而是承担材料流转中格式化、可归纳的部分,让时间回到论证与实验上。
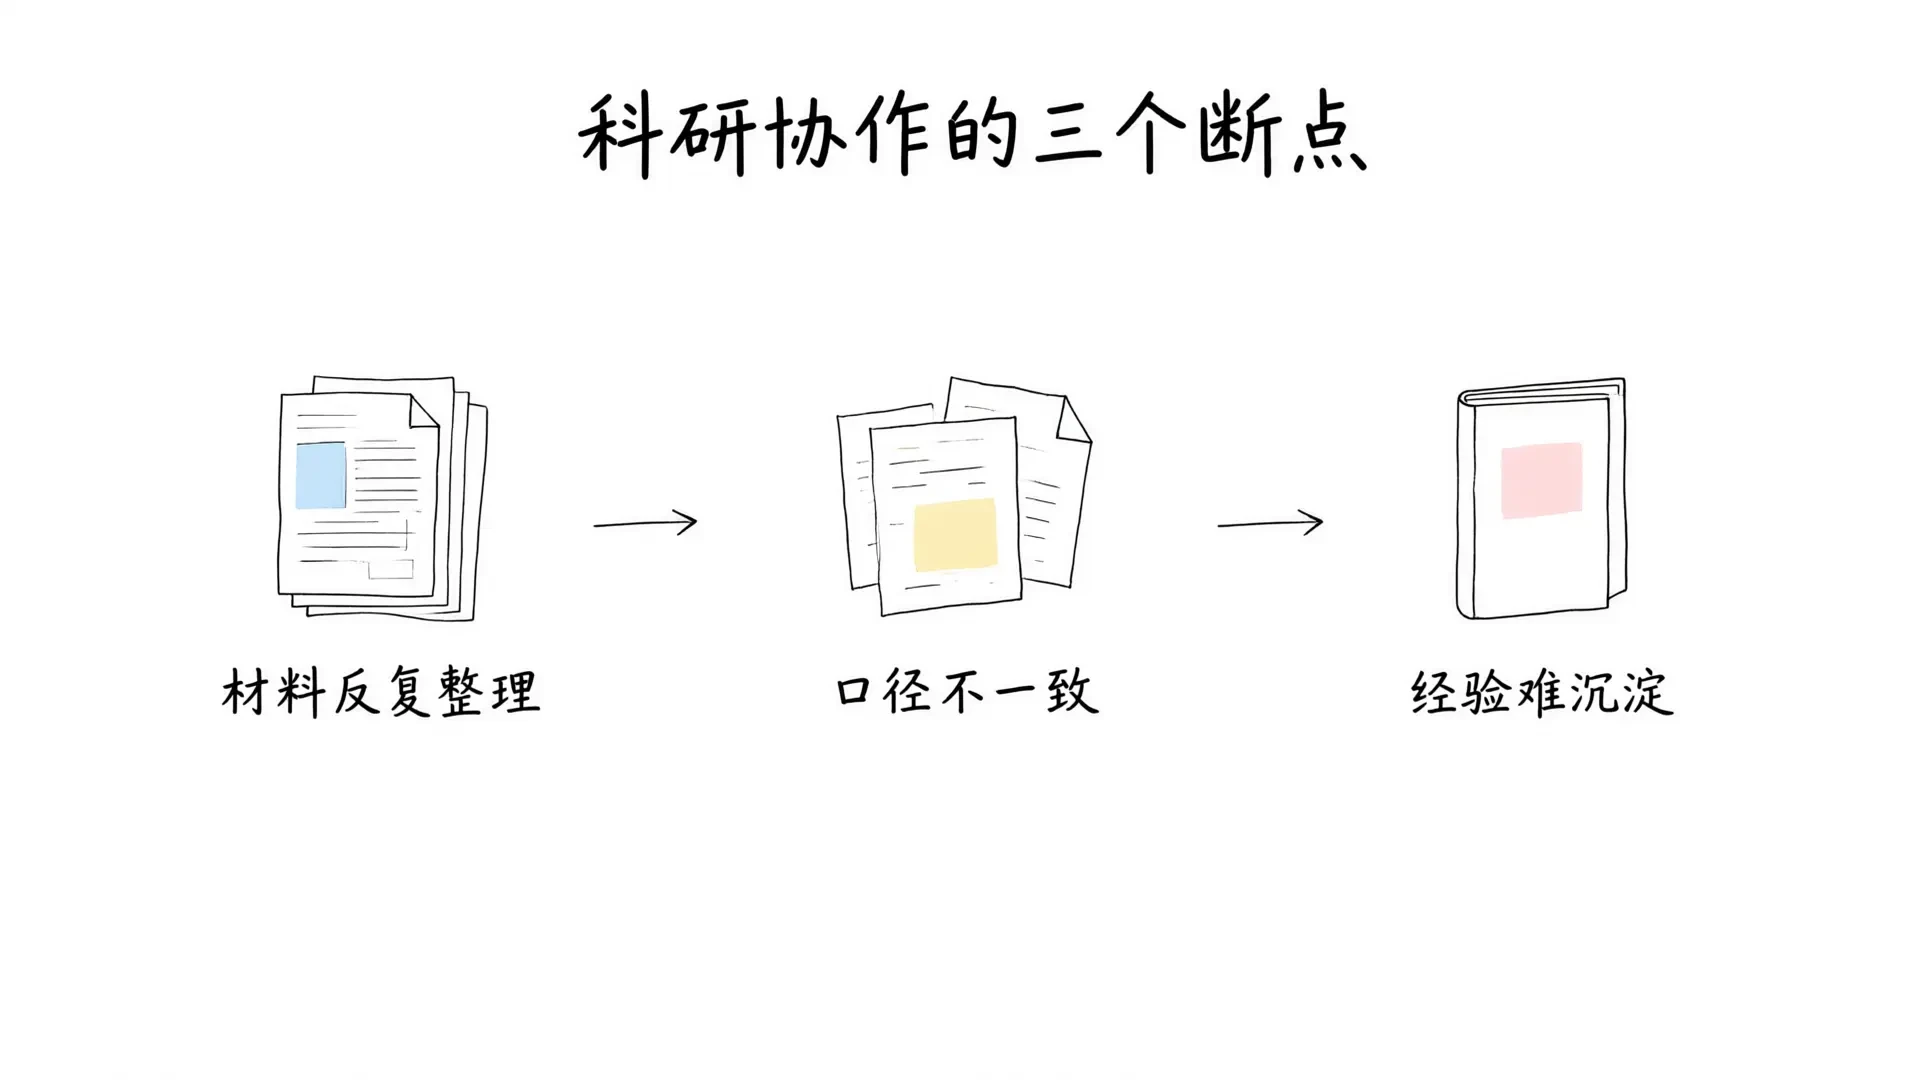
第一个断点:材料在重复劳动中被消耗
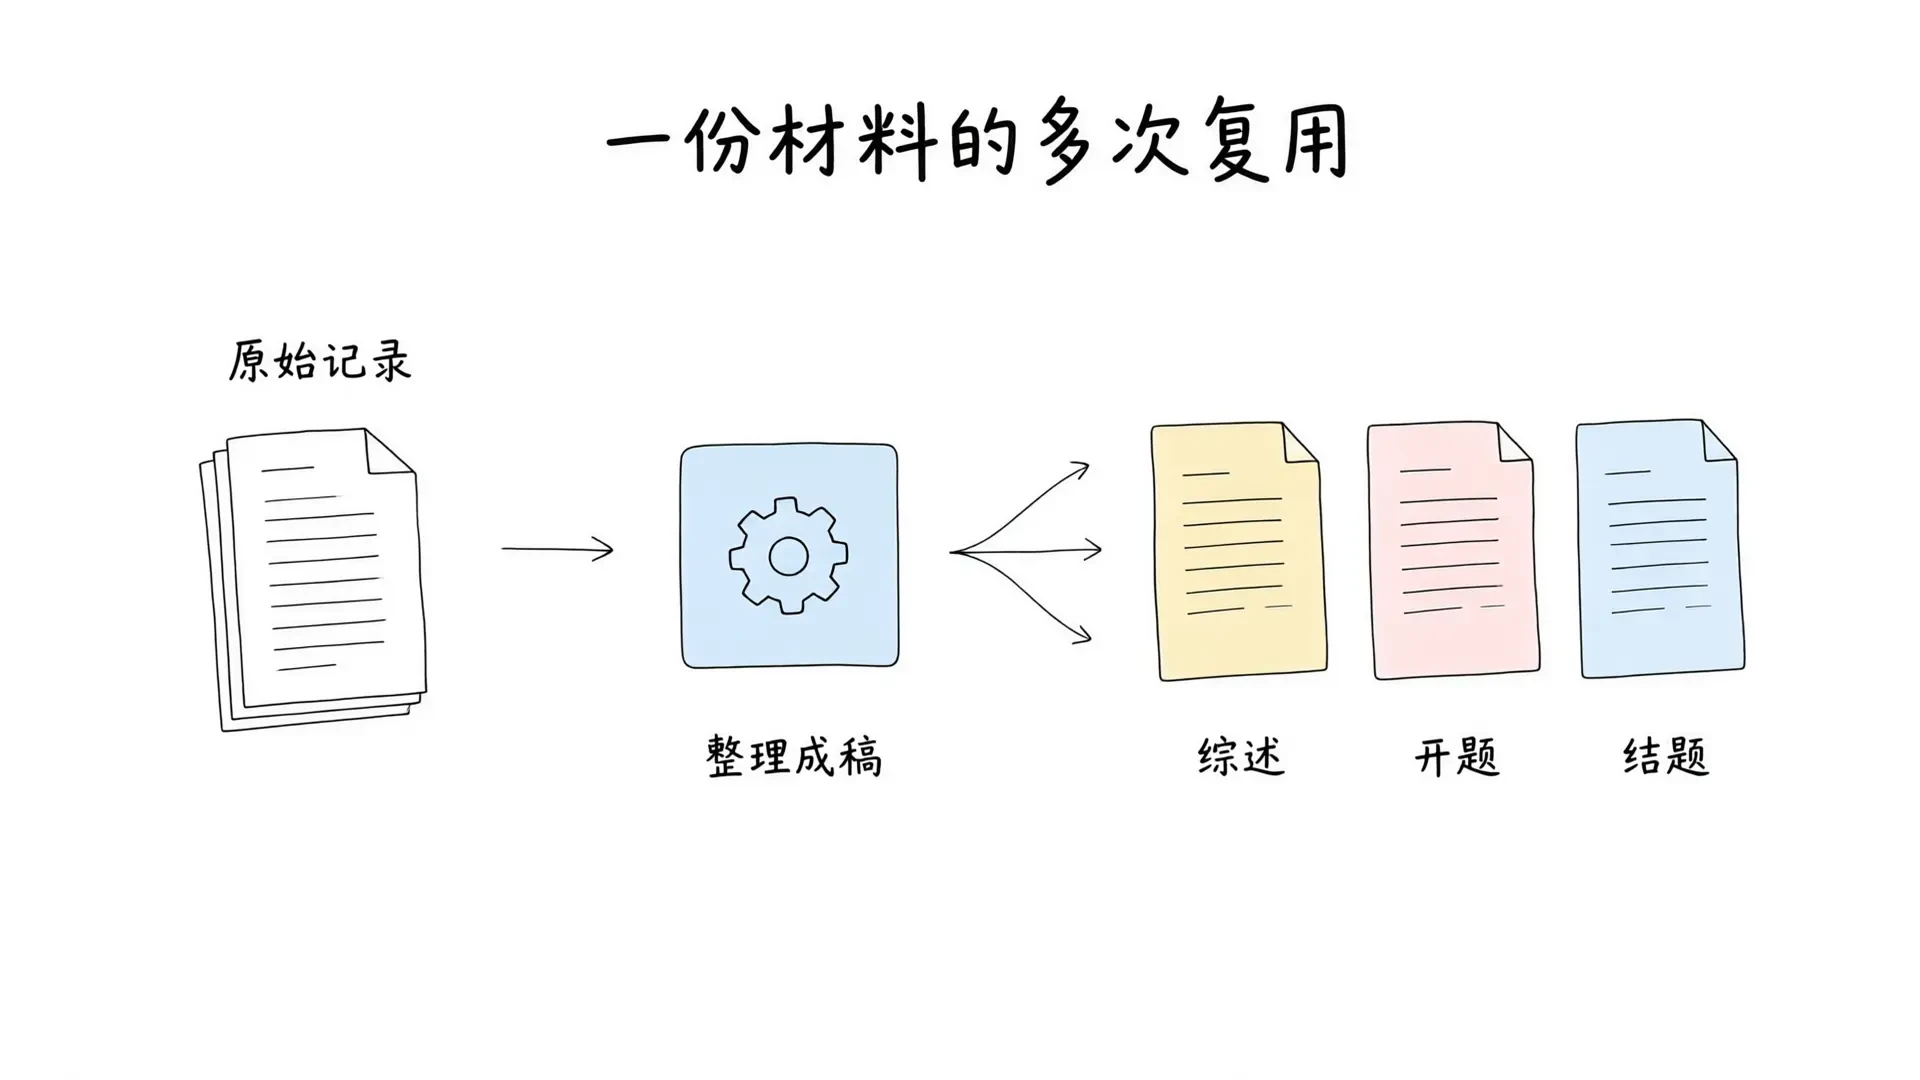
科研材料的共同特征是结构固定、信息重复。一份申报书里的团队介绍、前期基础、技术路线,往往在结题报告和后续项目里继续沿用;同一批文献,要在综述、开题、答辩材料里被重新整理三次以上。
WorkBuddy处理的是这类重复动作。多份文献按主题归并成可读的脉络,既有材料按模板字段抽取成结构化草稿,零散的记录整理成可继续修改的文字底稿。研究者拿到的是初稿,不是结论,判断权仍然在自己手里。这一步的价值可以用一个粗略口径衡量:一份材料从零写起,与在初稿上修改,投入的精力差一个量级。
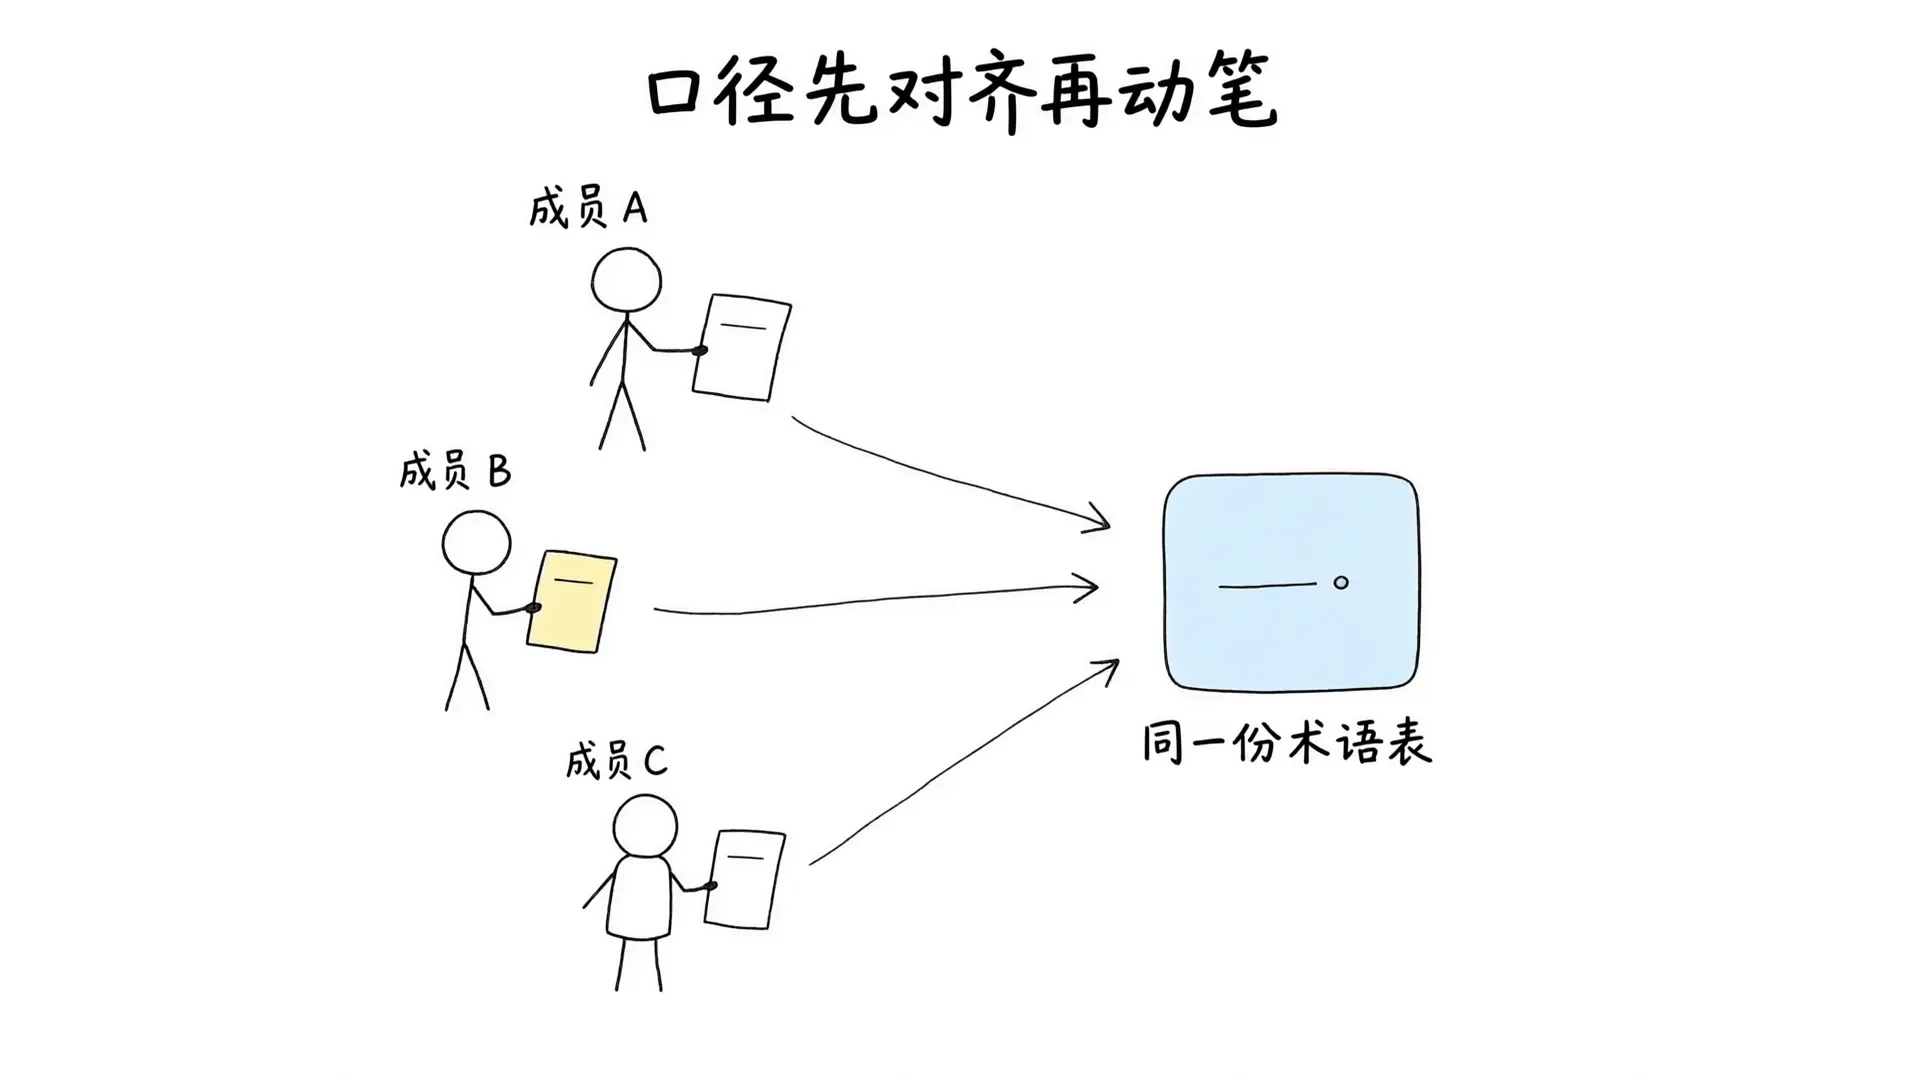
第二个断点:多人协作的口径不一致
跨课题组、跨院系乃至跨校合作的科研项目,最常见的问题是版本与表述。同一项技术在不同成员笔下写成三个名字,同一条数据在不同章节给出不一致的单位与口径,评审前才发现,返修代价很高。
WorkBuddy在这类场景里承担术语与表述的对齐工作。多人在同一份材料上并行起草,术语表与写作口径统一收敛,减少来回返修的轮次。这一条对联合申报尤其关键,因为评审看的是整体一致性,而不是某一段写得多好。
第三个断点:经验无法沉淀给下一届
课题组每年有人入学、有人毕业,文献综述的写法、申报书的话术、实验记录的规范,大多靠口头带教。人员流动一次,材料质量就波动一次。
把历史材料整理成可检索的参考,是WorkBuddy在长期使用中最容易被低估的部分。往期申报材料、答辩记录、结题报告积累下来,新成员起草时有据可依,导师的修改意见也从逐句批注变成框架调整。这也是我们在服务东南大学等高教客户时反复确认的一点:工具能不能留住组织的经验,比单个功能好不好用更重要。
落地路径:先诊后建,不要一次铺满
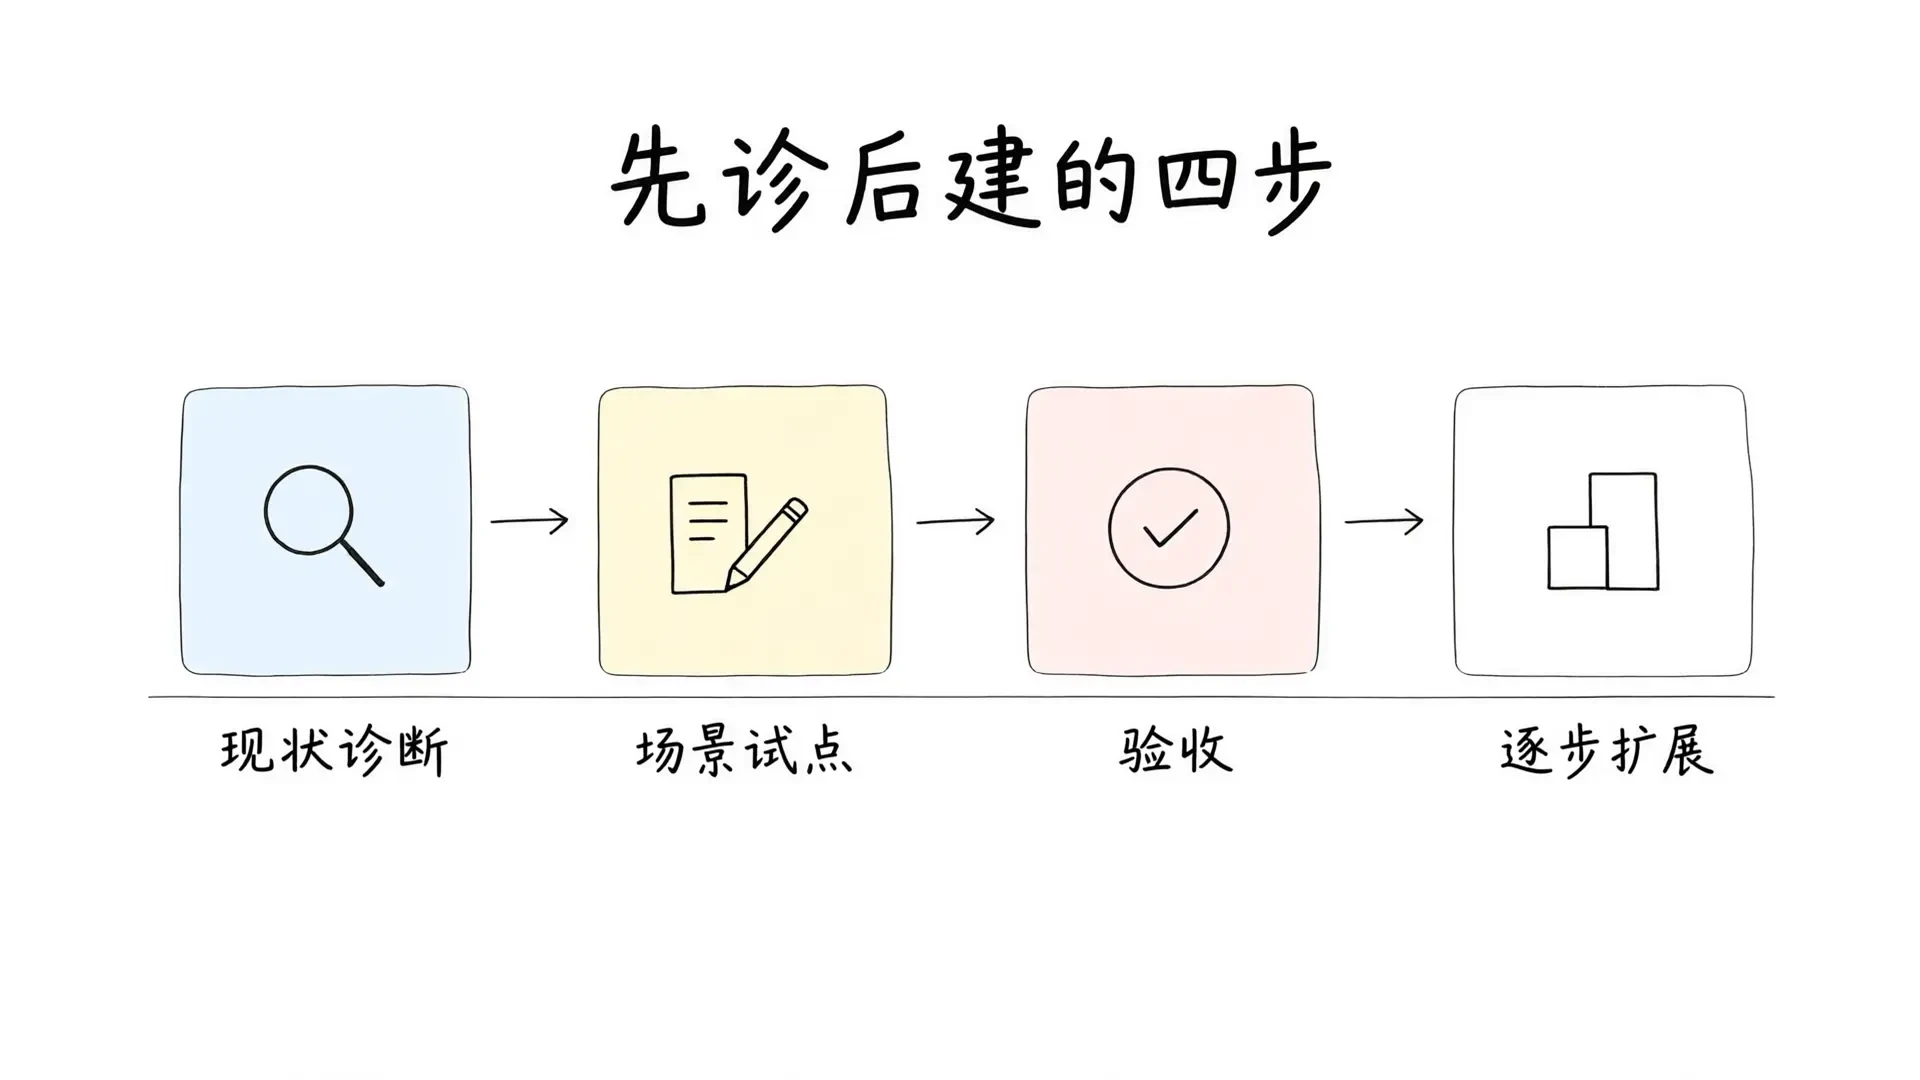
我们不主张高校一次性上全套工具。科研场景的差异很大,涉密项目、横向课题、教学与科研混编团队,对数据边界的要求完全不同。可行的做法是先诊后建、边诊边建:盘清团队的材料类型、权限分级和协作链路,选一两个高频场景做试点,验收通过再扩展。这条路径与我们在制造、政务领域做AI落地的判断一致。
三条边界需要提前划定。数据分级与权限要先于工具上线,未公开成果与涉密数据的使用范围必须有明确规则。AI生成的文字必须由研究者复核,不能直接作为申报材料定稿。工具还要与现有文献库、项目管理系统对接,避免形成新的信息孤岛。
结语
科研协作的效率,最终取决于材料在人与人之间流转时的损耗。AI千问办公WorkBuddy的位置就在这段流转里:把重复的整理、对齐、归档接过去,把判断与创造留给研究者。作为全栈AI解决方案服务商与软硬件一体化技术服务商,我们把这类工具放进“诊断+交付”的完整链路中评估,先看清团队的协作现状,再决定从哪里切入。